

MinerU是一个把PDF、扫描件与Office文档解析成可阅读结构的开源工具。它主要用来读取、解析、OCR、检索和引用文档,服务于需要把各类资料转成Markdown、再做摘要与问答的人。
它由opendatalab团队以开源项目形式维护,覆盖PDF、图片、Word、PPT、Excel、RTF、EPUB、OFD与HTML等格式。和一般PDF解析器或OCR库不同,MinerU面向本地文档工作流与长文档阅读:支持按页按块续读,不必把整篇塞进上下文,还能搜索已索引内容、取页面或区块图片目视核对,并用稳定定位符留住引用出处。
主要功能
- 多格式解析:把PDF、图片、Word、PPT、Excel、EPUB、OFD、HTML等文件抽取成Markdown,方便做分析、检索或入库。
- 扫描识别:对扫描件与拍摄图片做OCR,4.2版的行内公式和复杂版面识别更准,跨页表格也能合并。
- 长文续读:用按页按块续读代替把整篇塞进上下文,长资料可从上次的页与块接着读。
- 引用定位:以doc:{shortid}/tier:{tier}/page:{pageno}/block:{blockno}定位符锁定出处,便于摘引、回溯和后续追问。
- 文档库检索:缓存已处理文件,对已索引内容做搜索,还能取页面或区块图片目视核对。
- 多端入口:提供Python SDK、V1 API、批量转换、多服务Router与Gradio WebUI;V1的/tasks统一上传、状态查询与取消。
- 自主可控:小模型可选ONNX或Torch、视觉模型可选llama.cpp并自动检测硬件加速;默认本地解析,加–remote才远程且需同意。
适合谁用
- 需要读论文、财报或合同等长文档、又不想把整篇塞进上下文的研究者与职员。
- 手头有扫描件、拍照资料,需要OCR转成可编辑文字的行政与财务人员。
- 要把文档批量转成Markdown做检索、问答或入库的内容与数据团队。
- 重视数据不出本地、要求默认离线解析的隐私敏感行业从业者。
- 需要给答案附页块级出处、方便回溯核对的写作者与知识库维护者。
主要入口
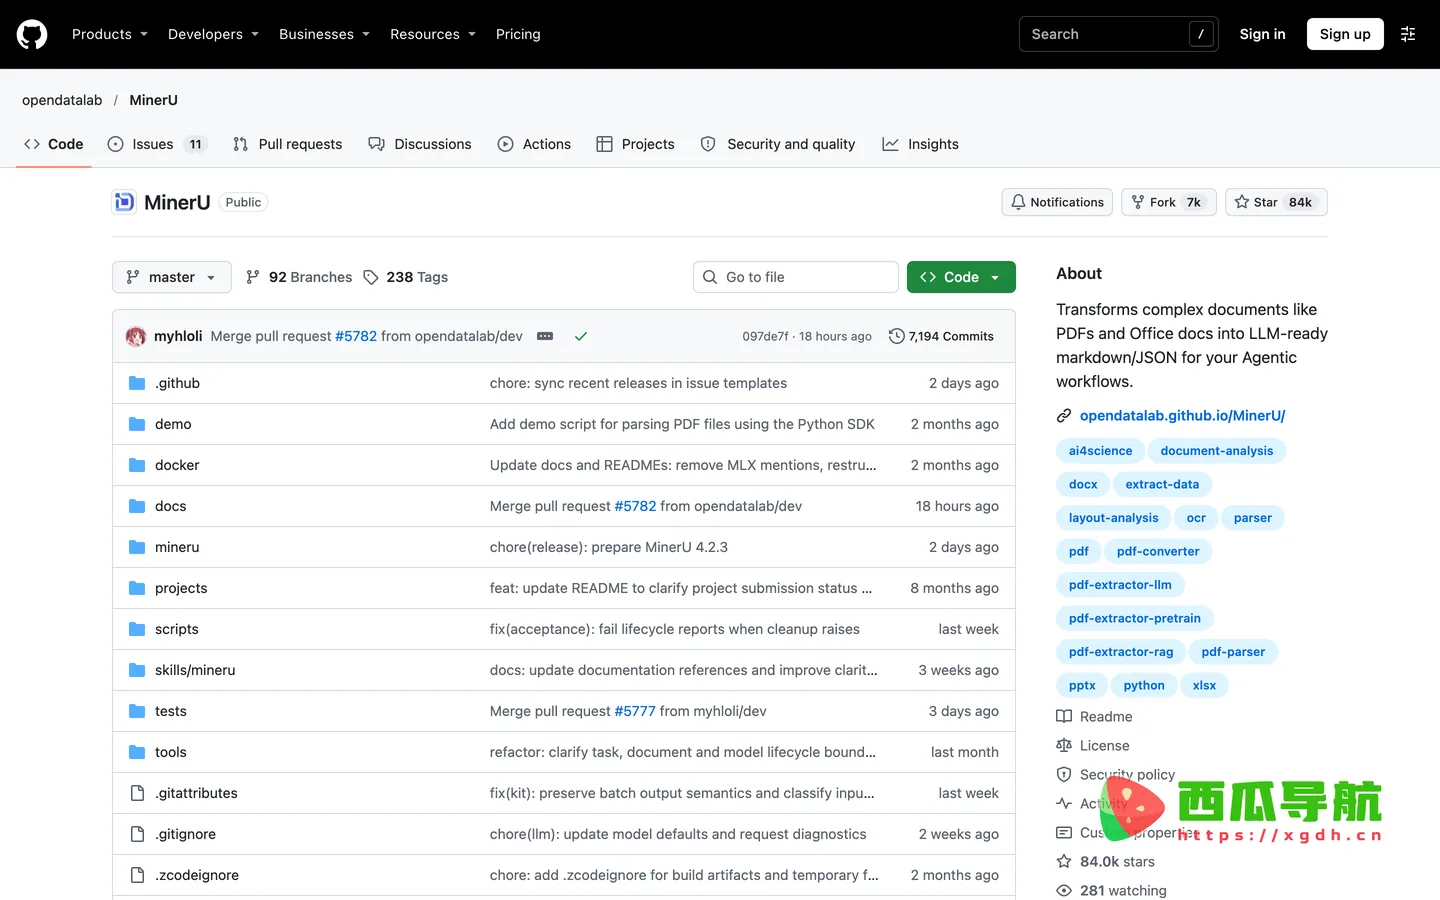
页面首屏按栏目铺开:Overview交代项目定位;Quick Start给出命令入口,并约定用–json做流程判断;
When To Use MinerU与Supported Inputs说明什么场景适用、能处理哪些格式;Core Decision Tree与Common Workflows把续读、摘要、OCR等路径串成决策参考;
Installation And Setup、Server Rules与Local Parse Server指向安装、服务端与本地解析配置;Privacy Rules、Telemetry与Quality Tiers说明本地优先、遥测和档位选择;
First Read From A File、Continue Reading、Read By Locator、Read Page Or Block Images、Search And Find则分别对应首次读取、续读、按定位符读、取页块图片与搜索查找。
同类对照
- 和通用PDF解析器相比:MinerU不止抽取文字,还能做公式、版面、跨页表格处理与按页块续读,长文档和结构化需求更合适。
- 和独立OCR库相比:它把OCR、格式转换、检索与定位串成一条链,适合要连续读并反复引用同一批资料的场景。
- 和其他文档解析工具相比:它默认本地解析、远程需先获同意,隐私敏感或需离线批量处理时优先选它。