言泉拼音输入法 (v2.7.0)
言泉是一个开源的 Windows 拼音输入法。没有广告,不捆绑软件,也不会上传你的输入记录——词库、设置和学习数据都只存在本机。代码全部公开,它做了什么,你随时可以查证。
温馨提示:本文发布于 2026-11-14,内容可能随时间推移而失效;若遇到链接打不开、资源异常等情况,可在下方「反馈」中告诉我们,我们会尽快核实处理。
软件简介:
言泉是一个开源的 Windows 拼音输入法。没有广告,不捆绑软件,也不会上传你的输入记录——词库、设置和学习数据都只存在本机。代码全部公开,它做了什么,你随时可以查证。
主要特性:
TSF 文本服务:注册、激活、组合生命周期的主流程已可用,并注册 TSF COM-less 能力类别,以适配采用该激活方式的宿主。TSF DLL 同时支持 Win64 与 Win32(svr.dll / svr32.dll),host 进程仅保留 Win64。
候选窗口:支持候选翻页、选词与上屏;可在设置中开启多行展开模式,翻页时最多显示三行候选,数字键选择当前行的词,Tab 补全区不受影响。
英文识别:中文全拼、半角输入时,英文单词和名称(如 pro、markdown、Effie)、带大写字母的输入以及曾按字母上屏的输入,可显示在编号候选之前。输入没有整词中文读法时默认选中,空格原样上屏;有中文读法时(如 bug、mac),由语言模型结合上文在字母与中文之间权衡:选中、只显示不选中,或不显示。中文候选的数字编号不变。默认开启,可在“常规”设置中关闭;双拼仍按中文处理。
光标旁的中英文提示:切换中英文时(默认按 Shift,也可用自定义快捷键或任务栏的输入指示器),光标上方短暂显示言泉 logo 和“中”或“英”;从其他输入法切换到言泉时(Win+Space、Alt+Shift 或任务栏的输入指示器)也显示当前状态。在英文状态下进入输入框时同样提示:英文状态直接输出字母,没有任何输入法的迹象;中文状态按下第一个键就会出现候选窗,因此不提示。提示不抢焦点、不拦截点击,按任意键即收起;在密码框中或取不到光标位置时不显示。默认开启,可在“外观”设置中关闭。
一键补全(言泉原创):候选窗每次只显示一个可信的续写方案,按配置键即可补全。用户词、基础词库 exact 词和离线复核的强转移补全立即显示;语言模型随后在后台重新排序,光标前有文字时一并参考。在长句中,它补完当前词或续写后面的短语,把握不足时不提示。
自定义短语:在“设置 > 自定义短语”中为短语设置字母快捷码。完整输入快捷码时,短语显示在一键补全区,按补全键原样上屏(包括换行);编号候选和空格不变。列表保持顺序,可用 JSON 导入导出。
长句:受词库约束的路径搜索给出完整候选(例如 womenjintian → 我们今天),同时保留前缀候选供分段上屏。语言模型在完整候选中选择,再对照输入的拼音和输入位置之前的文字,修正选中句子里少量的同音错字。
短词:多个精确候选竞争时由语言模型判断,光标前有已上屏的文字时一并参考。
短语:三到五个音节、词库里没有的输入(例如 jiuguize → 旧规则),由词库中的词拼出若干整句方案,语言模型结合光标前的文字选出一个,再对照输入的拼音修正同音字;把握接近时,首选之后最多再给出两个整句。
拼音方案:全拼及六种可选双拼方案(微软双拼、小鹤双拼、自然码双拼、搜狗双拼、紫光双拼和拼音加加)共用候选排序与用户学习数据;常见声母、韵母的模糊规则可独立配置;支持首字母简拼(例如 jt → 今天)。
词库:简体基础库、繁体基础库与用户词库相互分离。在“高级”设置中点“导入输入频次”,可导入其他输入法导出的词频(每行“词,拼音,次数”,逗号或 Tab 分隔),作为自己的选词习惯记入用户词库。
快捷输入:ufh 输入符号,uxh 输入数字序号,usx 输入数学符号,urq 输入当前日期;i123.45 或 v123.45 转换中文数字及金额大写。数字模式中数字键继续录入,按候选旁的 a/b/c/d、方向键加空格或鼠标选词;双拼需用 Shift+U/I/V 进入。详见快捷输入说明。
中文标点:中文标点、半角输入时,可在“常规”设置的“保持半角的符号”中指定原样输出的符号,也可一键换成 Markdown 预设或标准中文标点。默认的 Markdown 预设为 -#*+_=`~[]<>|@;逗号、句号、问号、感叹号、圆括号和引号仍按中文习惯输入,反斜杠输入顿号。
上下文同步:与应用同步光标前后的文本(surrounding text)和按键状态。
完全本地:不联网,不需要 GPU。语言模型尚未加载或不可用时,候选照常给出,只是不经过语言模型排序。
语言模型:
一个模型,管全部选词
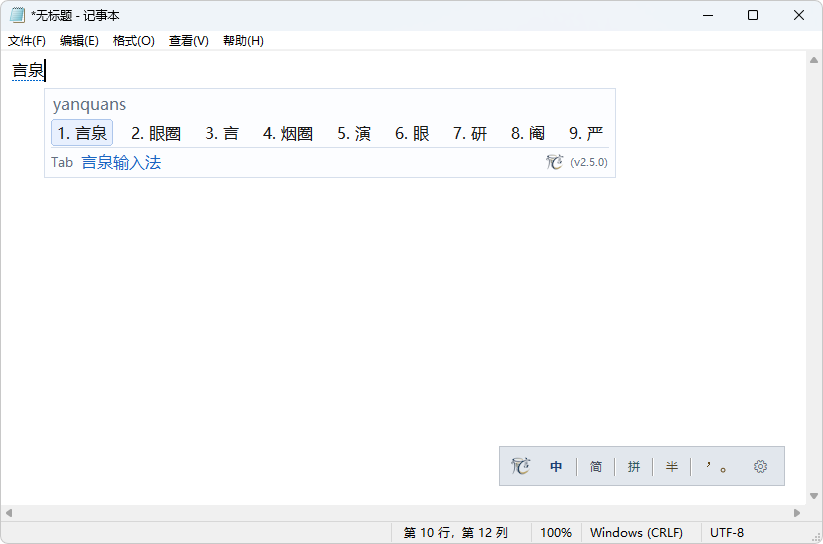
同样的拼音可以拆出很多种结果:yanquan 是「言泉」,也可以是「眼圈」「烟圈」。句子越长,可能的组合越多,引擎要在几十条路径里挑出你想说的那条。从 v2.0.0 起,这件事交给同一个本地语言模型,全程不联网。
第一阶段
v1.1 – v1.29
一路加模型
v1.x 的每个版本几乎都靠「再加一个模型」来改进:先是统计语言模型,然后是神经网络重排器、参与路径搜索的模型、受约束的 Transformer,再到拼音约束的局部纠错。每一步都让选词更准,也让整套东西越来越重:动一处,要重新校准一串。
第二阶段
v1.30 – v1.31
共享语言模型出现
v1.30.0 引入基于独立中文语料训练的共享字符级语言模型,把整句连贯性和前文语境用于长句选词、上下文短词和 Tab 续写;v1.31.0 升级模型,并让它参与补全的选择。到这时,安装包里有 11 个神经模型文件,引擎里还编译进 43 组模型参数,一次选词往往要依次经过其中好几个。
第三阶段
v2.0 起
只留一个
v2.0.0 把它们清掉了:神经模型从 11 个减到 1 个,引擎里的模型参数从 43 组减到 7 组。留下的是一个约 1.5 亿参数的字符级语言模型,由本项目自己训练,长句、短词、补全和同音纠错都问它;加载模型占用的内存从约 447 MiB 降到约 183 MiB。
这不是一次功能堆叠,而是一次收拾:以后的改进只需要做在一处,语言模型变好,所有输入场景一起受益。
模型只在外部 Host 进程中加载,后台就绪、仅用 CPU;未就绪或超时的时候,候选照常给出,只是不经过模型排序。代价是延迟:每个决定现在都要经过一个更大的模型,下面各项基准的耗时大多高于 v1.31.0(长句整句解码平均 73 ms 对 61 ms);日常逐键输入时,每个按键的响应通常仍在几十毫秒以内。以下各套基准测试的语料都与训练数据隔离,成绩里没有「背题」的水分。
更新日志:
v2.7.0
主要更新
语言模型学了日常对话。 语言模型从公开的对话语料 LCCC(MIT 许可)中,挑出最接近日常聊天的十分之一继续训练,再与原模型各取一半,六个排序模型也随之重训。小说和通用文本上的结果基本不变,聊天类文本明显变好:
逐键输入的聊天分句首选,无上文 72.44% → 73.94%,有上文 74.60% → 76.90%;
模型没有见过的聊天长句首选 69.00% → 71.15%,通用文本长句 61.58% → 62.15%;
长句一键补全命中 3944 → 3977。
没有上文时,日常用语保住首选。 词库新增一张日常对话的词频表。没有上文时,如果首选的词在日常对话里常见得多(30 倍以上),在通用文本里也不比另一个词少太多,词典权重又更高,它就不被换下。
候选框固定在输入的起点(#33)。 打字时候选框不再随光标向右跳,默认与输入的第一个字左对齐(和微信一样)。在设置的“外观 > 候选位置”里可以改回跟随光标;跟随光标时,从第四个字起候选框偏右的问题也已修复。
繁体和双拼也有了短语和长句纠错。 词库里没有的三到五个音节的短语,以及长句纠错,以前只在简体全拼下运行。本版繁体和双拼也用上了这两项,打字结果和简体全拼基本一致。
繁体:逐键输入的三到五字分句,首选从 33.3% 提高到 78.3%;繁体长句(官方长句案例转为繁体)首选从 75.95% 提高到 83.53%。
小鹤双拼:长句首选从 77.31% 提高到 84.55%,有上文的短词首选从 91.78% 提高到 97.64%。现在和全拼持平,有时略好,因为双拼的按键本身标明了每个音节在哪里结束。
有上文时,单字按上文排序。 前面已经打了字,再打一个音节时,单字的顺序由语言模型根据上文决定。在模型没有见过的文本上检验,单独成词的单字排在首位的比例:
通用文本:63.3% → 79.7%
小说:71.0% → 84.3%
聊天消息:76.4% → 82.3%
没有上文时,单字仍按使用频率排序,和 v2.6.0 一样。这一步要多运行一次模型:有上文、刚好打完一个音节的按键,平均从 2.0 毫秒增加到 5.6 毫秒。
长句纠错再检查一遍。 第一遍改过的句子会再检查一遍,一句话里有两处错时,第二处也有机会改过来。第一遍没有改动的句子不受影响。在四组模型没有见过的长句上,首选合计多对 81 句,少对 3 句。
新增智能ABC双拼。 zh、ch、sh 分别在 A、E、V 键上,零声母用固定的 O 键。码表和 Rime、fcitx 的智能ABC方案逐码一致,üe 和 ue 同在 M 键上(lm = lüe,lv = lü)。在设置的“拼音方案”中选择,状态浮窗显示“智”。
首个音节也可以拆成两个音节。 nianzhao 可以先选“你”(ni + anzhao),不只有 nian 的字。拆出来的字排在这个音节自己的字后面,不会占满首页:jiangzai 的首页是“将 讲 降 江 及 机 ……”,“及”在“将”之后。
分号、单引号选第二、第三个候选(#34)。 在设置的“快捷键 > 候选按键”里开启后,输入拼音时 ; 选第二个候选,’ 选第三个候选,数字键照常可用;没有正在输入的拼音时,两个键仍输入标点。默认关闭。开启后单引号不再用来分隔音节;微软、搜狗、紫光双拼中,声母后的分号仍是韵母 ing。
候选窗口右键菜单。 在候选窗口上点右键,会打开和托盘图标一样的菜单。正在输入的拼音不会因此消失。双显示器下,状态窗口不再在打开设置后跳到另一块屏幕。
繁体用字。 繁体状态下“么”按台湾的写法保留(老么)。繁体词库的用字也已改正,见下方词库更新。
词库更新。 新增约 2,350 个日常用语。按通用文本词频,重新调整了 834 个导入词的权重。繁体词库统一改用台湾用字,“鉅人”“農葯”“噹然”“囌州”改为“巨人”“農藥”“當然”“蘇州”。详见 cassotis-lexicon v2.7.0。
软件官网:https://www.yanquan.org/
开源地址:https://github.com/shenmin/cassotis-ime
软件截图:
在下方评论区发表一条评论,即可看到全部 4 个下载地址。